GLM-Image:開源圖像生成的新紀元
目錄
在快速發展的 AI 生成內容 (AIGC) 世界中,雖然 Diffusion 模型已成為業界標準,但它們通常難以應對兩個主要挑戰:遵循複雜的指令和呈現精確的文字。
最近,Z.ai 團隊推出了 GLM-Image。作為第一個開源、工業級的離散自迴歸 (AR) 圖像生成模型,它結合了大型語言模型 (LLM) 的「智慧」和世界一流的視覺效能。
立即嘗試
1. 核心架構:大腦與畫筆
GLM-Image 的決定性特徵是其創新的混合架構,它利用兩種強大技術之間的「雙打」方法:
「語義大腦」(自迴歸模組)
從 GLM-4-9B 初始化,此模組擁有 90 億個參數的純粹理解能力。它不只是「繪圖」;它還「閱讀」和解釋您的提示。透過使用 semantic-VQ 技術,它可以捕捉低頻語義訊號,並以驚人的準確度確定圖像的整體佈局。
「精美藝術畫筆」(擴散解碼器)
為了克服傳統 AR 模型的紋理和細節限制,GLM-Image 整合了一個 70 億參數的 DiT 擴散解碼器(基於 CogView4 架構)。它從大腦中獲取「語義藍圖」,並將其細化為高保真視覺輸出,確保每一根髮絲和每一道光線都完美呈現。
2. 主要優勢:為何 GLM-Image 脫穎而出
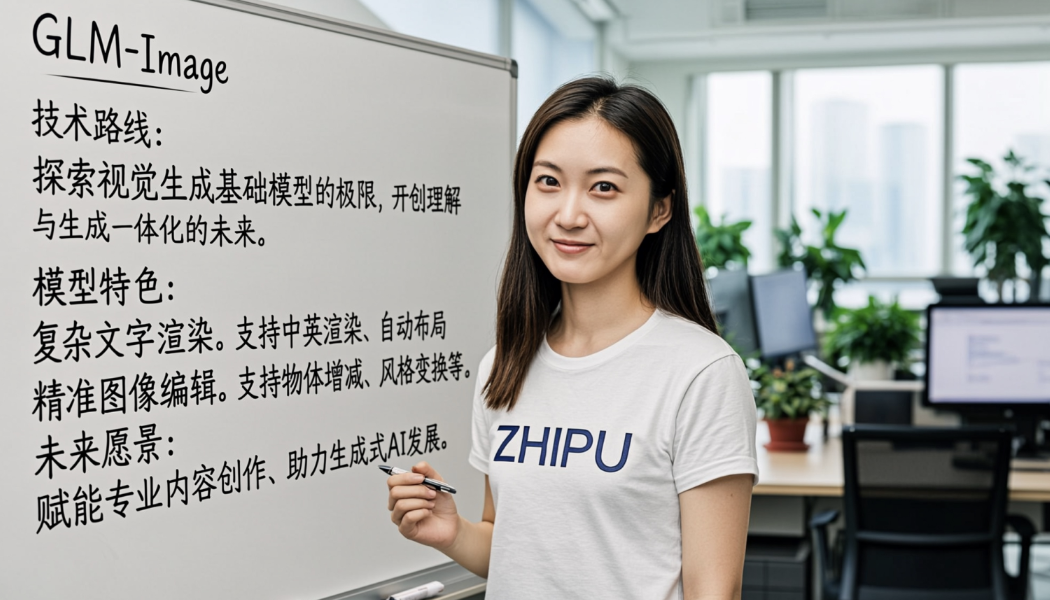
精準的文字渲染
這可能是 GLM-Image 最令人驚豔的突破。雖然其他模型在被要求包含文字時經常產生「亂碼」,但 GLM-Image 利用 Glyph-ByT5 技術專門用於字元級編碼——特別是對於中文字元。無論是複雜的漢字還是多行佈局,文字都保持清晰、準確且易於閱讀。
深度知識與語義對齊
由於其 GLM 根源,該模型擅長「知識密集型」場景。如果您要求包含特定歷史元素或複雜邏輯關係的場景,與純擴散模型相比,GLM-Image 不太可能「產生幻覺」,從而確保輸出既具有創造性又具有事實依據。
真正的「全能型選手」
GLM-Image 不僅僅是一個文字到圖像 (T2I) 工具。它原生支援:
- 圖像編輯: 精確修改特定區域。
- 風格轉換: 一鍵轉換藝術風格。
- 身分保留: 確保角色面孔在不同場景中保持一致。
- 多主體一致性: 管理複雜構圖中的多個不同物件。
3. 使用案例:從創造力到生產力
GLM-Image 將徹底改變幾個關鍵產業:
- 廣告與平面設計: 產生商業海報、標誌模型或帶有準確中文口號的產品頁面,從而顯著縮短修改週期。
- 內容創作與 IP 品牌: 憑藉其「身分保留」功能,創作者可以輕鬆開發故事書、漫畫或故事板,同時保持角色外觀的完美一致性。
- 電子商務與社群媒體: 快速建立高品質的產品圖像,並能夠精確地交換背景或調整光線。
- 教育與科學傳播: 產生帶有準確標籤和資料點的圖表和教育視覺效果,使視覺傳達更加嚴謹。
4. 結論
GLM-Image 的開源發布不僅是一個技術里程碑;更是對全球 AIGC 社群的一份禮物。它證明了 「AR + 擴散」 混合路徑是解決複雜視覺生成挑戰的非常有效的解決方案。
如果您正在尋找一款能夠理解中文、遵循邏輯並提供令人驚嘆的圖像品質的模型,那麼 GLM-Image 無疑是當今開源世界的首選。
開始你的下一次創作
使用 Story321 工具,將創意變為現實。
Generate Image